Seedance 2.5 الإشارة إلى الفيديو: دليل سير العمل R2V
Seedance 2.5 الإشارة إلى الفيديو (R2V) هي توليد مستند إلى المراجع: تعطي النموذج صورًا مختارة، مقاطع فيديو، صوتًا، أو مزيجًا منها لتوجيه الهوية والحركة وسلوك الكاميرا والمشهد والأسلوب والتوقيت. يستخدم تلك الأصول كتعليمات لمشهد جديد بدلاً من مجرد نسخ فيديو المصدر.
العمل العملي يتعلق أقل برفع كل الأصول التي لديك وأكثر بتعيين كل مرجع لمهمة واضحة واحدة. ابدأ بأصغر مجموعة يمكنها وصف المشهد، وسّمي تلك المهام في المطالبة، وأزل أي أصل يعطي توجيهًا متناقضًا. على Seedance AI ، الإدخال المختبر على الويب هو فيديو إلى فيديو مع Seedance 2.5. توثق واجهة برمجة التطبيقات العامة سير عمل مرجعي أوسع، لذا يفصل هذا الدليل ما كان مرئيًا في المنتج على الويب عما تم توثيقه وما لم يتم اختباره في 6 أغسطس 2026.
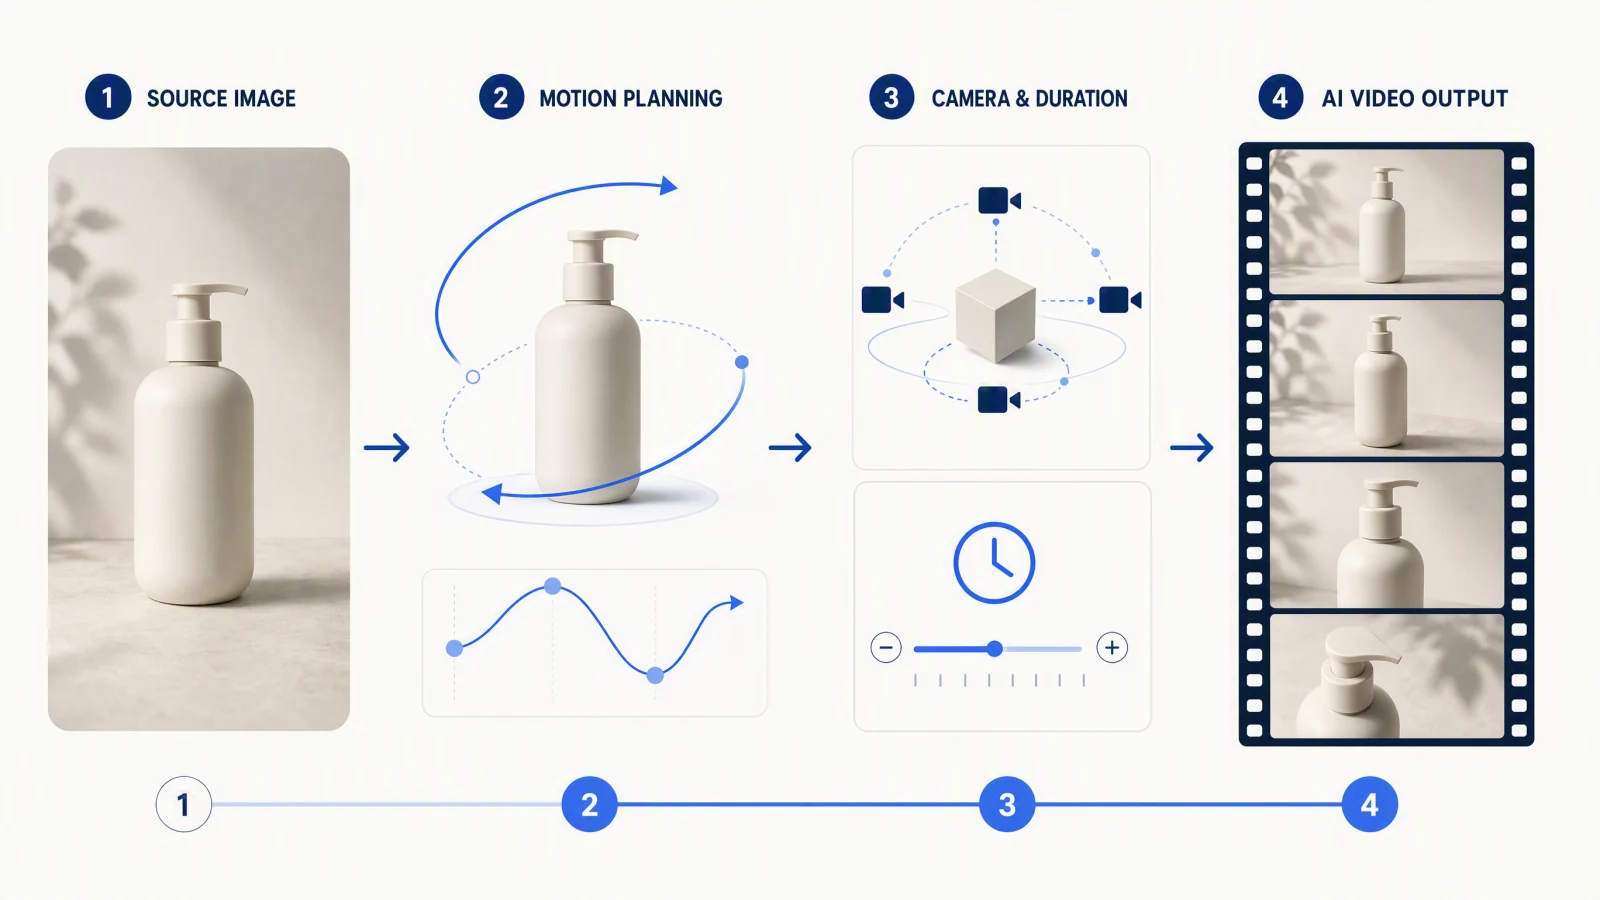
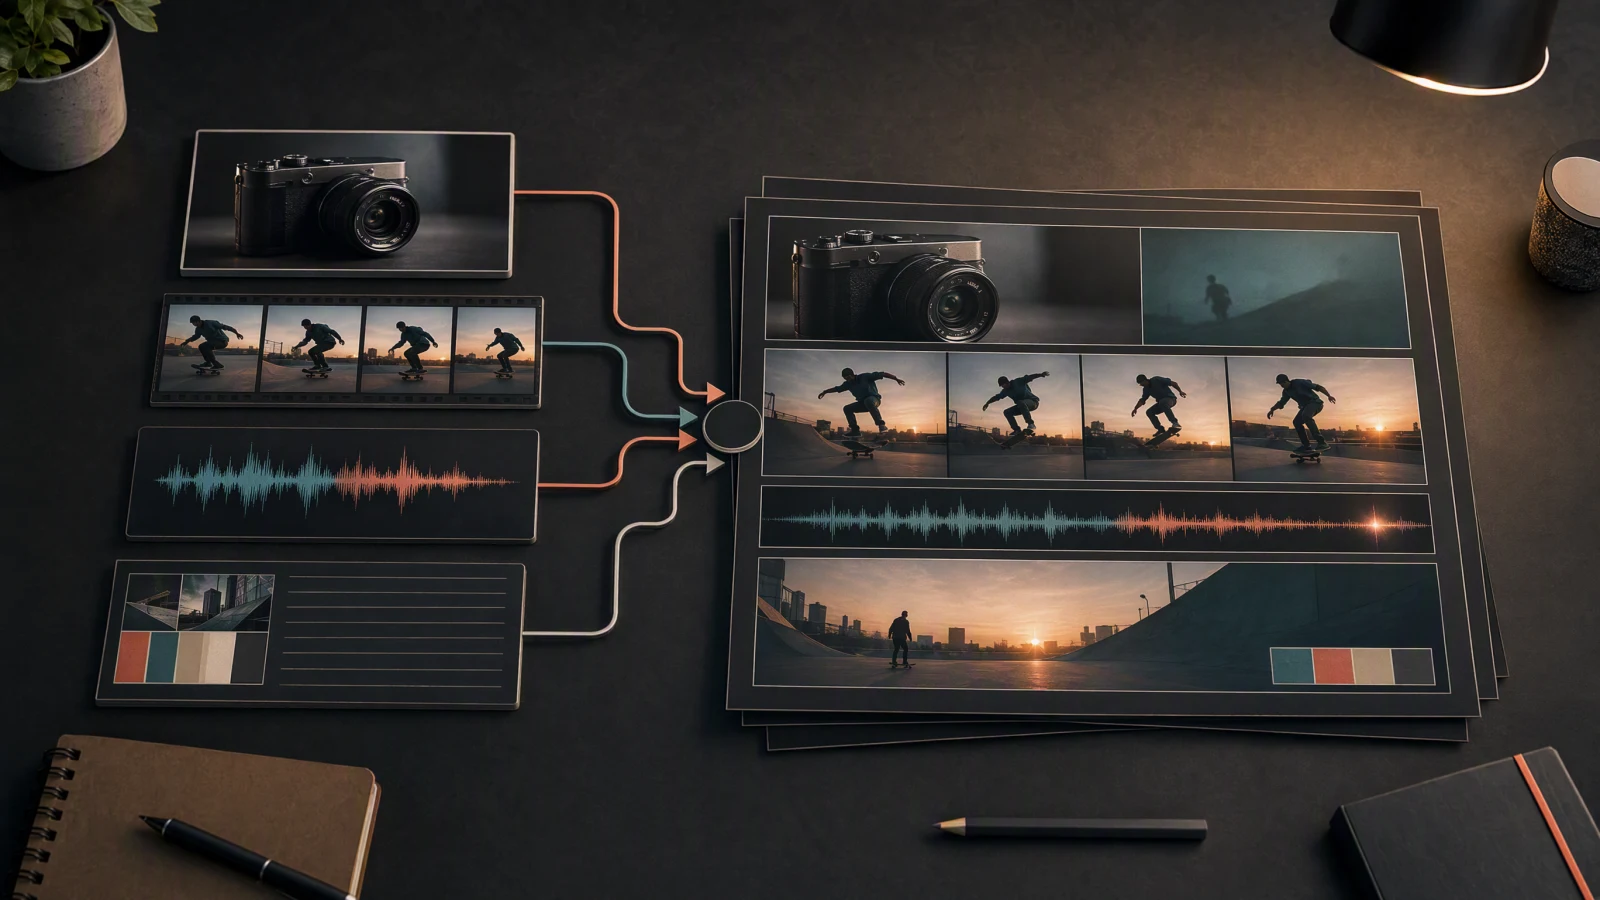 يمكن لمجموعة صغيرة من الصور والحركة والصوت والنصوص المرجعية أن توجه أجزاء مختلفة من مشهد واحد تم إنشاؤه.
ملخص سريع
- استخدم R2V عندما تحتاج عدة أجزاء من النتيجة إلى مصادر مرجعية منفصلة.
- قم بإعطاء كل أصل دورًا أساسيًا واحدًا، مثل الهوية أو الحركة أو الكاميرا أو الصوت.
- ابدأ بمرجعين إلى أربعة. أضف آخر فقط عندما يمكنك تسمية المعلومة المفقودة التي يزودها.
- إذا كان المرجعان متعارضان، اختر الفائز في الطلب أو أزل أحدهما.
- تحقق من الهوية والحركة والمساحة والكاميرا والصوت وحقوق الاستخدام قبل الموافقة على النتيجة.
إجابة سريعة
اختر R2V عندما لا يمكن لصورة بداية واحدة التعبير عن كامل الملخص. قد يحتوي حزمة إعلانية صغيرة للمنتج على صورة نظيفة واحدة للمنتج، وصورة واحدة للبيئة، ومقطع قصير للكاميرا أو الحركة، وملف صوتي اختياري. اخبر Seedance ما الذي يتحكم فيه كل عنصر. إذا انحرفت النتيجة، ابسط الحزمة قبل توسيع الموجه.
الفرق الجوهري بين R2V وتحويل الصورة إلى فيديو (I2V) أن المراجع تعليمات وليست الإطار الأول حرفيًا. اختبرنا ذلك بالصورة نفسها والمطالبة نفسها: افتُتح مقطع I2V على الصورة المرفوعة ثم انتقل بقطع إلى مشهد جديد في جزء من الثانية، بينما بنى R2V المشهد حول المنتج منذ الإطار الأول. انظر R2V مقابل I2V: الصورة نفسها والمطالبة نفسها.
حُدّث في 14 أكتوبر 2026: أُضيفت أربعة اختبارات توليد أجريناها بأنفسنا على Seedance 2.5 (مقارنة بين R2V وI2V بالمطالبة نفسها، ووصل مقطعين من R2V).
ما هو المرجع إلى الفيديو؟
يقوم R2V بإنشاء فيديو جديد من مجموعة من المراجع. قد تحدد صورة واحدة المنتج، وأخرى الموقع، وقد يوضح مقطع الحركة، وقد يحدد ملف صوتي الإيقاع. الموجه يربط هذه القطع من خلال تخصيص الأدوار.
هذا يختلف عن الفيديو العادي إلى الفيديو. في V2V ، عادةً ما يكون المقطع الموجود هو المصدر الزمني الرئيسي والمهمة هي التحويل أو التعديل أو إعادة التصميم. يمكن لـ R2V استخدام فيديو كتعليم واحد بين عدة تعليمات، دون الحاجة لأن يكرر الناتج كل إطار أو حدث.
المرجع ليس نفس النسخ. يمكن للمصدر أن يؤثر على الشكل أو الحركة أو التكوين أو الإيقاع، لكن النموذج ما زال يولد نتيجة جديدة. راجع المخرجات للتفاصيل المخترعة ولا تفترض أن توفير مرجع يضمن الهوية الدقيقة أو هندسة المنتج أو الترتيب الحركي.
R2V مقابل I2V مقابل الإطار الأول/الأخير مقابل الفيديو إلى الفيديو
| الوضع | الإدخال الرئيسي | ما الذي يتحكم فيه بشكل أفضل | أفضل للاستخدام | ليس الأفضل للاستخدام |
|---|---|---|---|---|
| المرجع إلى الفيديو (R2V) | عدة صور أو مقاطع أو ملفات صوتية، أو مزيج منها | أدوار منفصلة مثل الهوية والحركة والإعداد والكاميرا والتوقيت | موجز معقد يحتاج إلى أكثر من مصدر واحد | لقطات بسيطة تحددها صورة واحدة بالفعل |
| صورة إلى فيديو (I2V) | صورة بداية واحدة | التكوين الافتتاحي، مظهر الموضوع، والتخطيط الابتدائي | تحريك صورة ثابتة مع الحفاظ على مظهرها الابتدائي | اقتراض الحركة والصوت من مصادر منفصلة |
| الإطار الأول/الأخير | صورة بداية وصورة نهاية | الافتتاحية، الخاتمة، والانتقال بينهما | الكشف المخطط، التحولات، وحركات الكاميرا مع وجهة معروفة | مشاهد مفتوحة بدون إطار نهائي مطلوب |
| فيديو إلى فيديو (V2V) | مقطع موجود واحد | التوقيت، الأداء، مسار الكاميرا، وهيكلية التحرير | إعادة تصميم أو تغيير مقطع المصدر مع الحفاظ على حركته | بناء مشهد جديد من مراجع مستقلة |
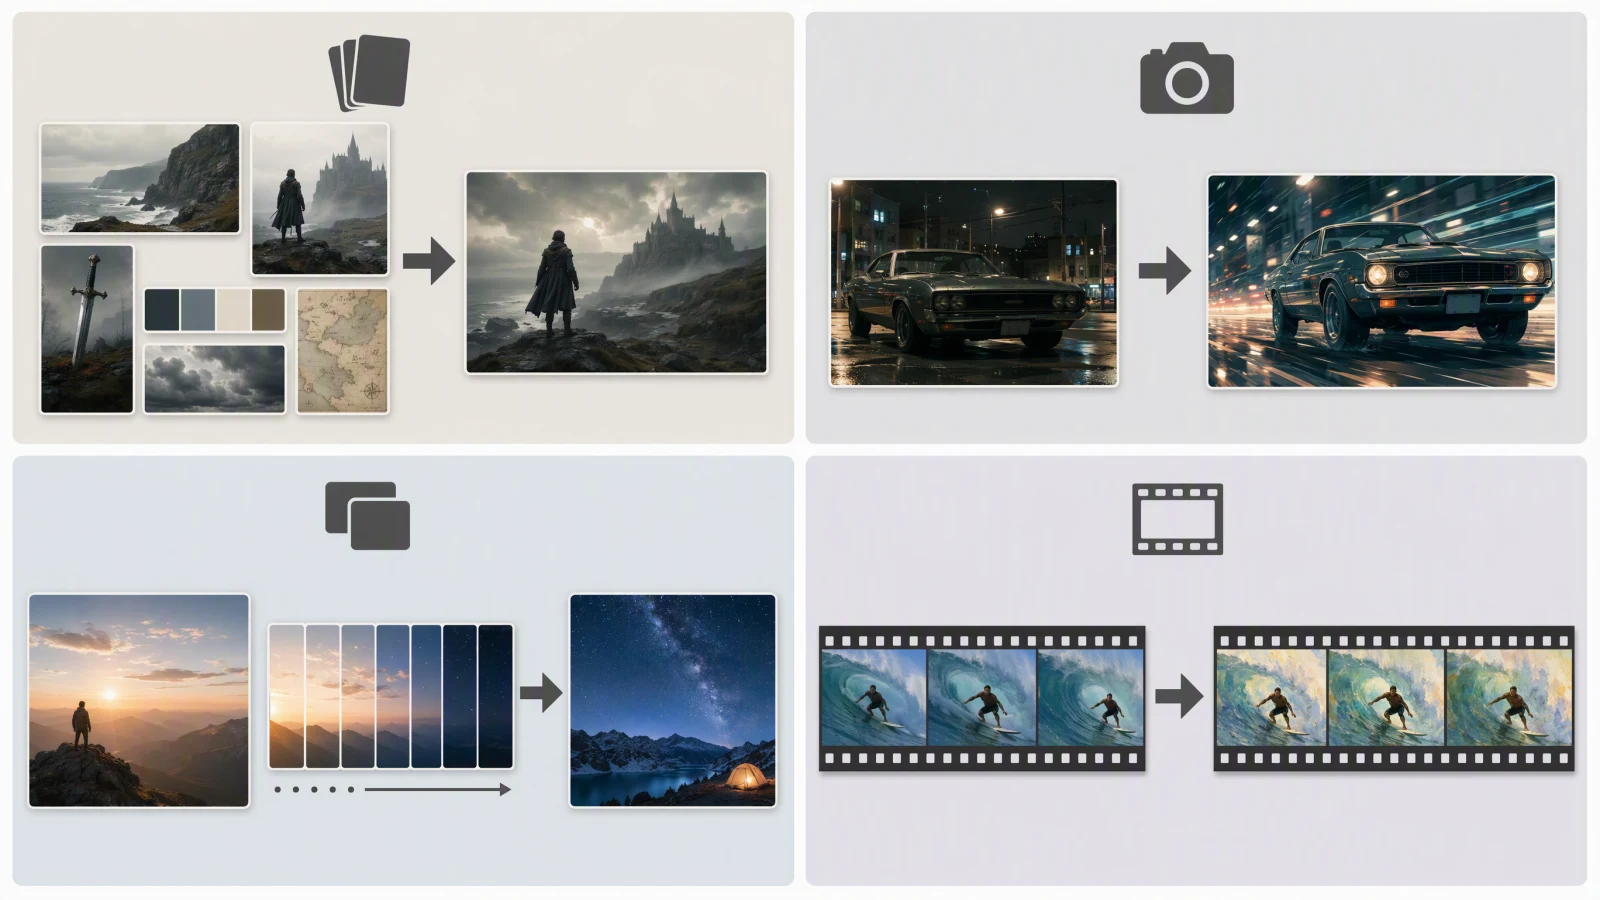 يقوم R2V بدمج المصادر المحددة حسب الدور، بينما تبدأ I2V ، الإطار الأول/الأخير، و V2V كل منها بإدخال بصري أكثر هيمنة.
R2V مقابل I2V: الصورة نفسها والمطالبة نفسها
في 14 أكتوبر 2026، أعطينا Seedance 2.5 صورة منتج واحدة ومطالبة واحدة مرتين: مرة كتحويل صورة إلى فيديو مع الصورة كإطار أول، ومرة كتحويل مرجع إلى فيديو مع الصورة بصفة @image1. كان المقطعان بطول 4 ثوانٍ ودقة 480p مع إيقاف الصوت، ووُلّد كل منهما مرة واحدة. الصورة بديل مولّد بالذكاء الاصطناعي لزجاجة ماء بلون كريمي بغطاء من الخيزران، مصوّرة على خلفية بيضاء سادة.
The cream stainless-steel water bottle with the bamboo cap from @image1 stands on a light oak kitchen counter in soft morning window light. A hand enters, unscrews the bamboo cap, and sets it down beside the bottle. Slow push-in toward the bottle. Keep the bottle shape, color, and cap identical. No text, no logos.
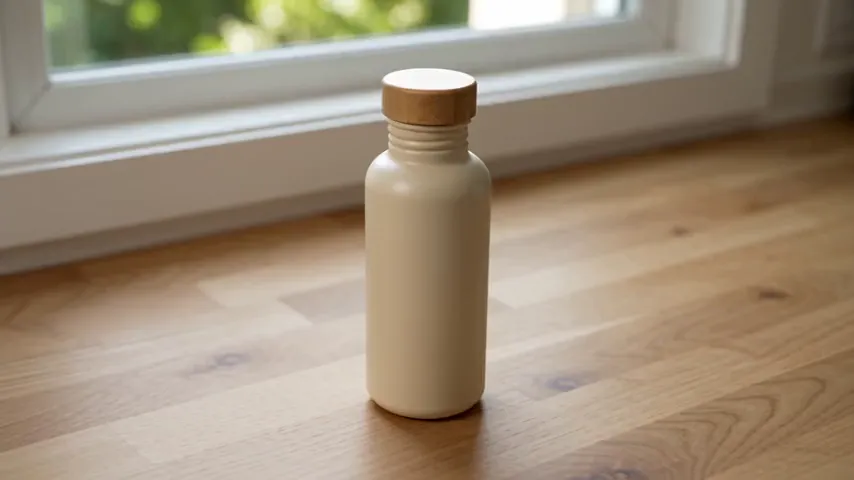
في الأعلى: توليد I2V، ويفتتح على الصورة المصدر. في الأسفل: توليد R2V من الصورة نفسها. كلاهما المقطع الكامل ومدته 4 ثوانٍ (بتشغيل متكرر).
| الفحص | I2V (الصورة كإطار أول) | R2V (الصورة بصفة @image1) |
|---|---|---|
| اتساق الموضوع | الغطاء واللون والعنق المضلّع تطابق الصورة؛ ويخرج جسم الزجاجة أعرض قليلًا | الغطاء والشكل متطابقان؛ ويتحول اللون الكريمي إلى بيج أغمق |
| الحركة | يد تفك الغطاء وتضعه جانبًا: تحقق | يد تفك الغطاء وتضعه جانبًا: تحقق |
| الخلفية | تبقى صورة الاستوديو البيضاء نحو 0.1 ثانية، ثم قطع حاد إلى سطح من البلوط تحت ضوء الشمس | يبني سطحًا خشبيًا بجوار نافذة منذ الإطار الأول، دون قطع |
| الكاميرا | اقتراب طفيف | اقتراب طفيف |
| الرصيد على Seedance AI | 12 رصيدًا لمدة 4 ثوانٍ بدقة 480p | 12 رصيدًا، السعر نفسه |
| مدة التوليد | نحو 5 دقائق | نحو 5 دقائق |
ما يُظهره ذلك: يتعامل I2V مع الصورة المرفوعة على أنها الإطار الافتتاحي حرفيًا. وعندما تطلب المطالبة مكانًا مختلفًا، يضطر النموذج إلى الخروج من ذلك الإطار، وقد فعل ذلك هنا بقطع قافز واضح في الإطارات الأولى. أما R2V فيتعامل مع الصورة نفسها كوصف للمنتج ويضعه في المكان الجديد منذ البداية، مقابل انحراف طفيف في اللون. استخدم I2V عندما تكون الصورة هي اللقطة التي تريد الافتتاح بها أصلًا، واستخدم R2V عندما تكون الصورة موجودة فقط لتحديد المنتج أو الشخص ويجب أن يكون المشهد جديدًا. لم يضع أيٌّ من التوليدين الزجاجة على سطح من البلوط الفاتح: كان I2V الأقرب، وجاء خشب R2V أغمق.
حالة القدرة والحدود المؤكدة
القيود تتبع للمنصة التي تكشف عنها. لا تعامل واجهة أو وثائق منصة واحدة كحد عالمي Seedance للحد.
| الواجهة | الحالة | ما تم التحقق منه | تاريخ التحقق |
|---|---|---|---|
| Seedance AI مولد الويب، Seedance 2.5 ، من فيديو إلى فيديو | تم الاختبار | أظهرت الواجهة بعد تسجيل الدخول ما يصل إلى 9 صور مرجعية وفيديو مرجعي اختياري بتنسيق MP4/MOV بطول 2 إلى 15 ثانية. وقد كشفت عن عناصر التحكم الخاصة بالمطالبات، نسبة العرض إلى الارتفاع، المدة، الجودة، وإخراج الصوت. | 2026-08-06 |
| Seedance AI وثائق واجهة برمجة التطبيقات العامة | موثق | Seedance قوائم التوليد المرجعية 2.5 تحتوي على ما يصل إلى 30 صورة، 10 فيديوهات، و 10 ملفات صوتية، مع إخراج يتراوح مدته بين 4 إلى 30 ثانية بجودة 480p أو 720p. | 2026-08-06 |
| Dreamina Seedance صفحات 2.5 | موثق | Dreamina يصف R2V متعدد الوسائط، بما في ذلك الحركة، الشاشة الخضراء، والنموذج الأبيض. تعرض صفحة المنتج إمكانية ما يصل إلى 50 مرجعًا وتوليد مدته 30 ثانية في ذلك المنتج. | 2026-08-06 |
| Seedance 2.5، توليدات R2V وI2V بمدة 4 ثوانٍ ودقة 480p | تم الاختبار | زوج واحد من I2V مقابل R2V بالمطالبة نفسها وسلسلة R2V من مقطعين، توليد واحد لكل منها، والنتائج في هذا الدليل. أربعة توليدات لا تمثل قياسًا لمعدل النجاح. | 2026-10-14 |
| تم الانتهاء من Seedance AI إخراج R2V متعدد المراجع | لم يُختبر | لا يتم هنا تقديم أي ادعاء حول دقة الهوية، مصداقية الحركة، التزام الصوت، أو معدل النجاح لتوليد متعدد الوسائط مكتمل. | 2026-08-06 |
تختلف أرقام الويب و API لأنها تصف أسطحًا مختلفة. اتبع الضوابط المعروضة على السطح الذي تستخدمه. حدود تنسيق API محددة أيضًا: صور JPEG أو PNG أو WebP ؛ فيديو MP4 أو MOV ؛ وصوت MP3 أو WAV. راجع الوثائق الحالية Seedance AI للنموذج قبل إعداد حزمة كبيرة.
خريطة أدوار المرجعية
يجب أن يجيب كل أصل على سؤال واحد. إذا لم تتمكن من تحديد ما يسيطر عليه الأصل، فاتركه خارج المحاولة الأولى.
| الدور | ما الذي يجب أن ينقله المرجع | مصدر جيد | نزاع شائع |
|---|---|---|---|
| الهوية | من أو ما يجب أن يبقى قابلاً للتعرف عليه | ورقة شخصية نظيفة أو صورة منتج | وجهان مختلفان، أو ملابس مختلفة، أو نسخ مختلفة من المنتج |
| المنتج | الشكل، موضع الملصق، المادة، واللون | صورة أمامية، جانبية، أو تفصيلية بإضاءة محايدة | صورة مصممة تغير النسب أو تخفي الجيومتريا الأساسية |
| البيئة | التخطيط، المقياس، اتجاه الإضاءة، والخلفية | لوحة موقع واسعة أو مفهوم مجموعة بسيطة | وجهة النظر والإضاءة تتعارض مع مرجع الموضوع |
| Motion | فعل الجسم، مسار الجسم، أو الإيقاع الفيزيائي | مقطع حركة قصير وقابل للقراءة | الحركة تتطلب وضعية أو دعامة غائبة عن مصدر الهوية |
| Camera | الإطار، إحساس العدسة، المسار، والسرعة | مقطع Previs أو بسيط تحريك مسار الكاميرا | حركة الكاميرا تقاوم الحجب أو تكشف عن الفراغ المفقود |
| Style | لوحة ألوان اللوحة والنسيج والتباين ومعالجة العرض | لوحة مزاجية متماسكة أو إطار مظهر | عدة صور نمط تتجه نحو لغات بصرية غير مرتبطة |
| الصوت | موسيقى، حوار، أجواء، أو صوت cue | مسار نظيف مع التوقيت المقصود | الإيقاع الصوتي لا يتطابق مع الإجراء المطلوب |
| التوقيت | ترتيب ومدة الأحداث | ورقة الإيقاع، لوحة القصة، أو المطالبة | تم حشر الكثير من الأحداث في المدة المحددة |
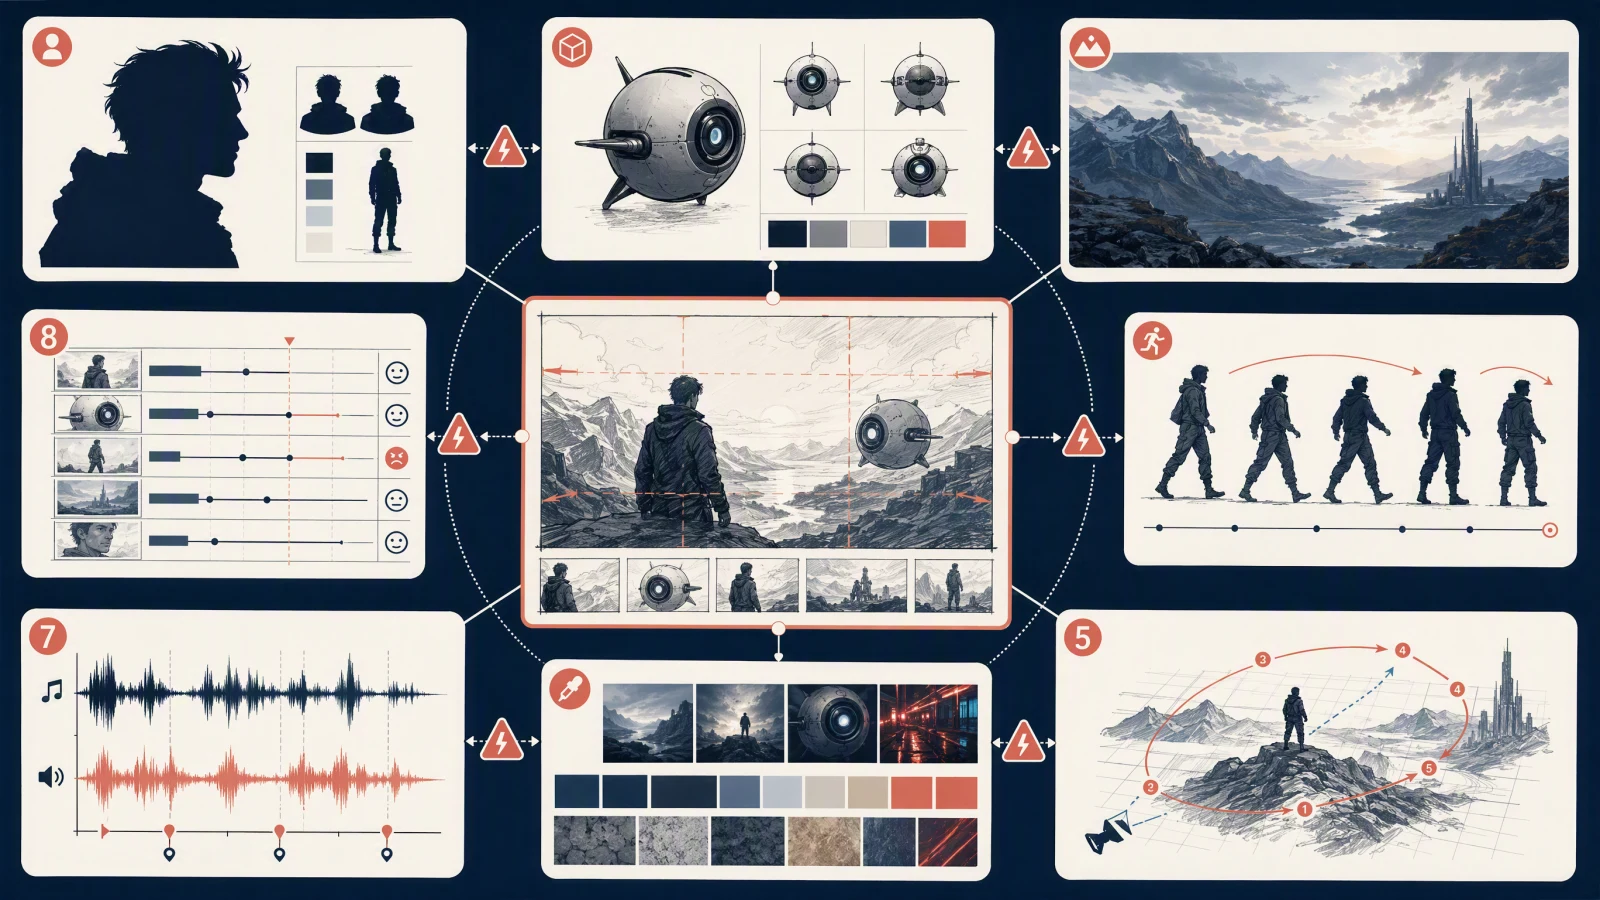 خريطة الأدوار تفصل الهوية، المنتج، البيئة، الحركة، الكاميرا، الأسلوب، الصوت، والتوقيت، لذا يصبح من الأسهل اكتشاف الصراعات.
ابن حزمة مرجعية صغيرة وغير متعارضة
ابدأ بالموجز، وليس الحد الأقصى للتحميل. اكتب جملة واحدة للمشهد، ثم ضع خطاً تحت التفاصيل التي لا يمكن التعبير عنها بالكلمات بمفردها بشكل موثوق. تلك هي المرشحة لتكون مراجع.
استخدم هذا الترتيب:
- اختر المرساة. بالنسبة لإعلان المنتج، عادة ما تكون صورة المنتج هي النقطة الأساسية. بالنسبة للقطة الأداء، قد تكون هوية الشخصية أو مقطع الحركة هي النقطة الأساسية.
- أضف مرجعا واحدا لأصعب متطلب ثانوي. غالبا ما يكون هذا بسبب الحركة أو الكاميرا أو البيئة.
- أضف الصوت فقط عندما يؤثر الإيقاع أو الصوت أو الأجواء أو إشارة الصوت على الصورة.
- تعيين كل أصل في الملف بأسماء صريحة، مثل div
@image1,@video1، أو@audio1، عندما تدعمها الواجهة. - اقرأ الموضوع مرة واحدة من وجهة نظر كل أصل. إذا بدا أن أصولين يسيطران على نفس العقار بشكل مختلف، أزل أحدهما أو حدد أيهما يفوز.
الحزمة الأولى المفيدة غالبا ما تحتوي على أصولين إلى أربعة أصول. الحد الأقصى الموثق هو السعة، وليس هدفا.
سير عمل R2V خطوة بخطوة في Seedance AI
الخطوات التالية تتطابق مع Seedance AI التي كانت مرئية في 6 أغسطس 2026.
- Open Seedance AI وإدخال مولد الفيديو.
- اختر Video to video، ثم اختر Seedance 2.5 من قائمة النموذج.
- أضف الحد الأدنى من صور المرجع المطلوبة للهوية، المنتج، الأسلوب، أو البيئة. يسمح التحكم المرئي عبر الويب بما يصل إلى تسع صور.
- إذا كان هناك حاجة لمصدر مرئي للحركة أو سلوك الكاميرا، أضف فيديو مرجعي واحد. التحكم المرئي يقبل مقاطع MP4/MOV من 2 إلى 15 ثانية.
- اكتب موجهًا يحدد وظيفة كل إدخال. حدد الموضوع، الفعل، المكان، الكاميرا، التوقيت، وأي مرجع يكون له الأفضلية إذا تداخل مصدران.
- اختر نسبة العرض إلى الارتفاع المتاحة، المدة، الجودة، وإعداد إخراج الصوت للوجهة.
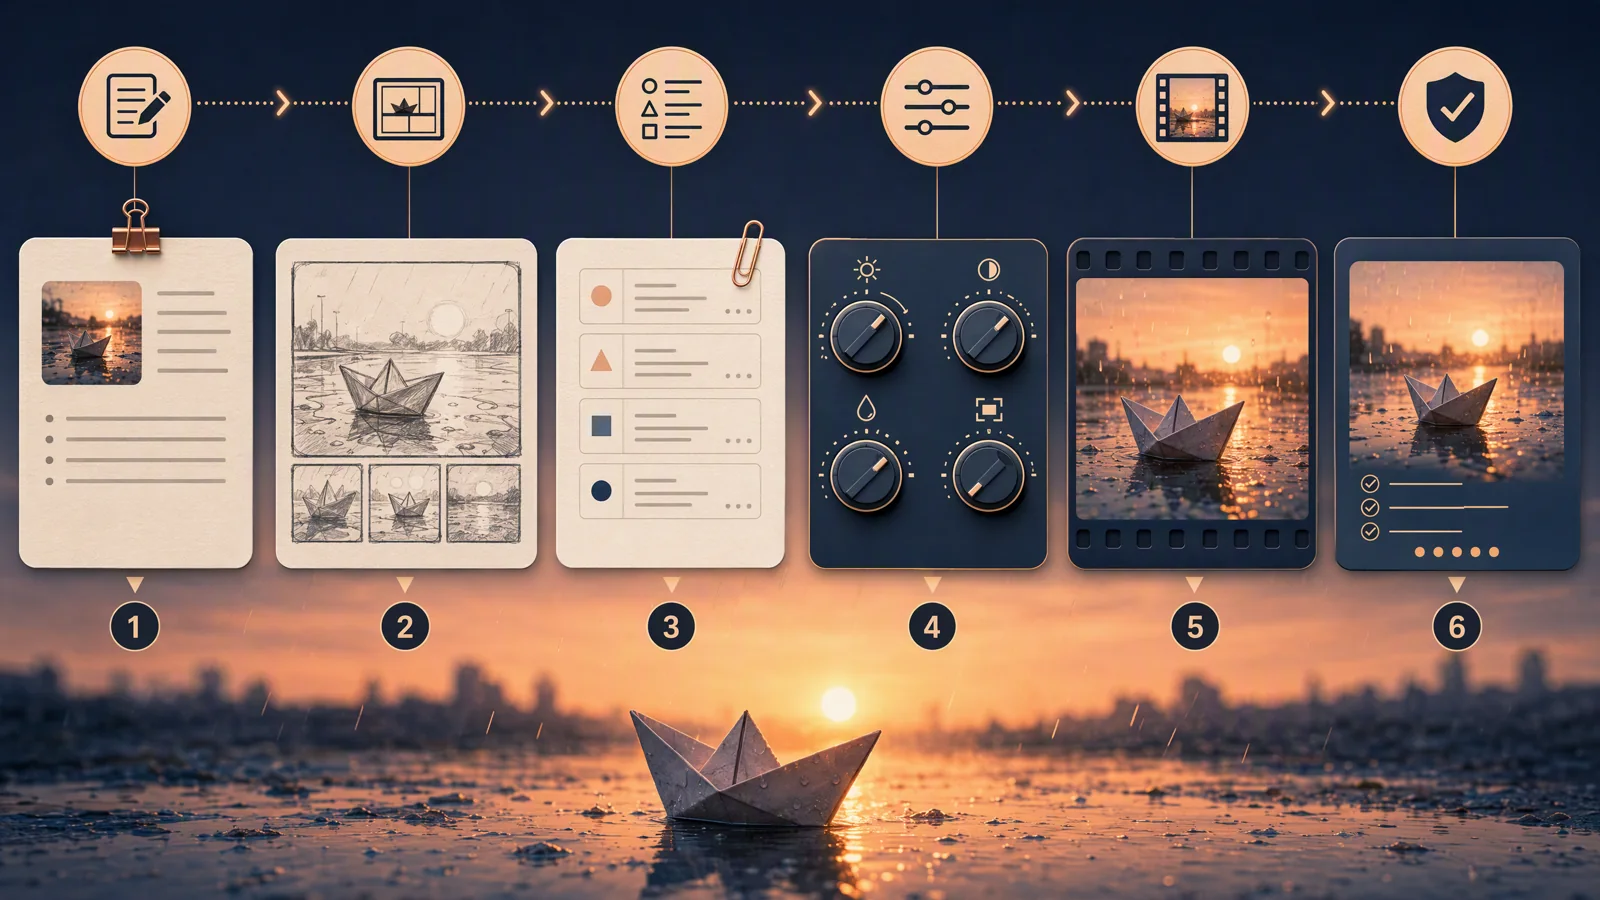
- أنشئ مسودة. راجعها مقابل خريطة الأدوار بدلاً من السؤال عما إذا كانت تبدو مثيرة للإعجاب فقط.
- غيّر متغيرًا واحدًا في كل مرة. أزل مرجعًا متضاربًا، أو قص الفعل، أو وضّح دورًا واحدًا قبل إضافة المزيد من المواد.
للمقدمة الأساسية للنموذج، استخدم Seedance دليل إعداد 2.5. إذا كانت صورة واحدة كافية، فإن Seedance دليل الصورة إلى الفيديو 2.5 هو سير العمل الأبسط. يغطي الدليل الأقدم Seedance دليل مرجع الفيديو 2.0 مسار منتج مختلف.
ثلاثة أمثلة كاملة لحزم المراجع
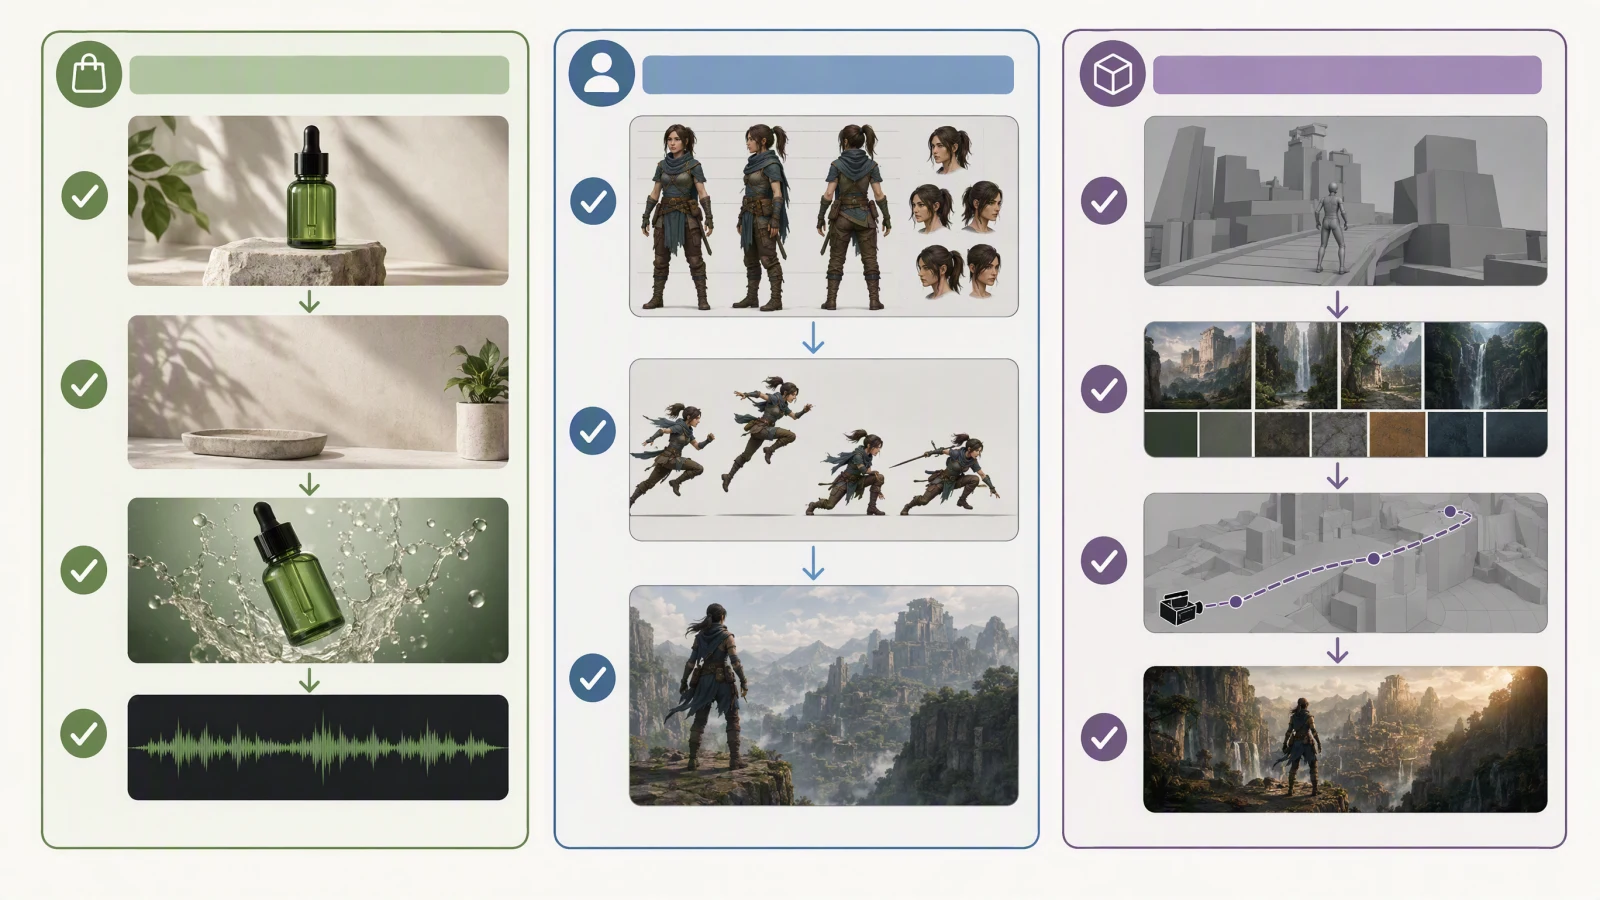 تتضمن كل حزمة المصادر اللازمة فقط لوصف مرجعها الأساسي، وأصعب المتطلبات الثانوية، والتوقيت.
حزمة إعلان المنتج
| الأصل | الدور | ما المطلوب طلبه |
|---|---|---|
@image1: صورة نظيفة للمنتج |
مرساة المنتج | الحفاظ على شكل الزجاجة، موضع الغطاء، المادة، ومكان الملصق |
@image2: سطح حجري عند الغسق |
البيئة | استخدام السطح، عمق الخلفية واتجاه الضوء الجانبي |
@video1: دوران بطيء على الطاولة |
الكاميرا والتوقيت | اتبع سرعة الدوران وانتهِ عند الملصق الأمامي |
@audio1: نبضة اختيارية ست ثوانٍ |
توقيت الصوت | ضع المنتج النهائي عند الدوران الأخير على آخر نبضة |
نمط الطلب: "استخدم @image1 لشكل المنتج وموضع الملصق. ضعه في بيئة المنضدة من @image2. اتبع الدوران البطيء والتوقف النهائي المواجه للأمام من @video1. احرص على أن تكون هندسة المنتج أولوية أعلى من أي شكل مرئي في مقطع الحركة."
حزمة حركة الشخصية
| الأصل | الدور | ما المطلوب طلبه |
|---|---|---|
@image1: ورقة شخصية من الأمام ومن زاوية ثلاثة أرباع |
الهوية | الحفاظ على الوجه، الشعر، الملابس، ونسب الجسم |
@video1: مقطع حركة نظيف |
الحركة | اتباع القفزة، الدوران، الهبوط، والإيقاع التقريبي |
@image2: لوحة الموقع |
البيئة | وضع الحركة على السطح الظاهر دون نسخ شخص آخر |
حافظ على بساطة مقطع الحركة بصريًا. يمكن لشاشة خضراء أو مصدر غير مزدحم أن يجعل الحركة أسهل في القراءة، لكن هذا لا يلغي الحاجة للتحقق من اليدين، نقاط الاتصال، الملابس، واتساق الوجه.
نموذج أبيض تمهيدي إلى مجموعة المظهر النهائي
| الأصل | الدور | ما الذي يجب طلبه |
|---|---|---|
@video1: نموذج أبيض تمهيدي أو صندوق رمادي تمهيدي |
التحجيم، الكاميرا، والتوقيت | الحفاظ على ترتيب اللقطات، مسار الكاميرا، والمواقع الرئيسية |
@image1: مفهوم البيئة النهائي |
البيئة والأسلوب | استبدال المجموعة الرمادية بالهندسة المعمارية والإضاءة المقصودة |
@image2: مرجع الشخصية أو المنتج |
الهوية | استخدام الموضوع المعتمد بدلًا من الهندسة البديلة |
النموذج الأبيض هو خطة مكانية، وليس مرجعًا لمظهر نهائي. قل ذلك مباشرة. وإلا، قد يرث الناتج مواد رمادية أو أشكال بديلة كانت مقصورة فقط على التحكم في الحجب.
مراجع الصوت والتوقيت
يمكن للصوت أن يوجه ثلاثة أشياء مختلفة: ما يُسمع، موعد حدوث الحدث، وكيف يشعر التعديل. حدد أيها مهم. "استخدم هذا الصوت" غير واضح؛ "ابدأ دفع الكاميرا على الإيقاع الأول وكشف المنتج على الإيقاع الرابع" يعطي للصوت دورًا في التوقيت.
احتفظ بالحوار والموسيقى والمؤثرات منفصلة عند الإمكان. المسار المختلط يجعل من الصعب تحديد الإشارة التي يجب على النموذج اتباعها. إذا لم تكشف الواجهة عن تحميل مراجع الصوت، فصف بنية الإيقاع في المطالبة أو استخدم سير عمل واجهة برمجة التطبيقات الموثقة بدلًا من افتراض وجود عنصر التحكم على الويب.
البحث عن المراجع المتضاربة وإصلاحها
عادة ما يظهر الصراع على شكل انحراف أو تسوية أو عدم استقرار. قد يستعير الموضوع ميزات من صورتين للهوية. قد يتطلب مقطع الكاميرا مساحة لا تحتوي عليها صورة البيئة. قد يضغط إيقاع صوتي سريع حركة تحتاج إلى وقت أطول.
استخدم ترتيب الإصلاح هذا:
- حدد الخاصية التي فشلت: الهوية، الهندسة، الحركة، المكان، الكاميرا، الأسلوب، الصوت، أو التوقيت.
- اعثر على كل مرجع يحاول التحكم في تلك الخاصية.
- احتفظ بالمصدر الأكثر وضوحًا وأزل الباقي.
- اذكر الأولوية في جملة واحدة.
- قم بالتوليد مرة أخرى قبل تغيير متغير آخر.
المطالبات الأطول لا تحل الأدلة المتناقضة. الوضوح في الملكية هو ما يفعل ذلك.
وصل مقطعين من R2V: نتائج الاختبار
أقصى مدة لتوليد واحد على Seedance 2.5 هي 30 ثانية. وللقصص الأطول يمكنك تشغيل R2V مرتين: يستخدم الجزء الثاني مراجع الهوية والبيئة نفسها في المواضع نفسها، ويُضاف ختام الجزء الأول بصفة @video1 كمادة تسليم بين الجزأين. في 14 أكتوبر 2026 جرّبنا هذه الطريقة بأقل تكلفة ممكنة: جزآن مدة كل منهما 4 ثوانٍ بدقة 480p بدل 30 ثانية، لفحص نقطة الوصل فقط.
استخدم الجزء الأول ثلاث صور مرجعية بديلة مولّدة بالذكاء الاصطناعي: امرأة بكنزة بلون الشوفان بصفة @image1، ومطبخ أبيض فارغ بصفة @image2، وزجاجة الماء الكريمية بصفة @image3. وأعاد الجزء الثاني استخدام الصور الثلاث في المواضع نفسها، وأضاف الجزء الأول كاملًا (4 ثوانٍ) بصفة @video1.
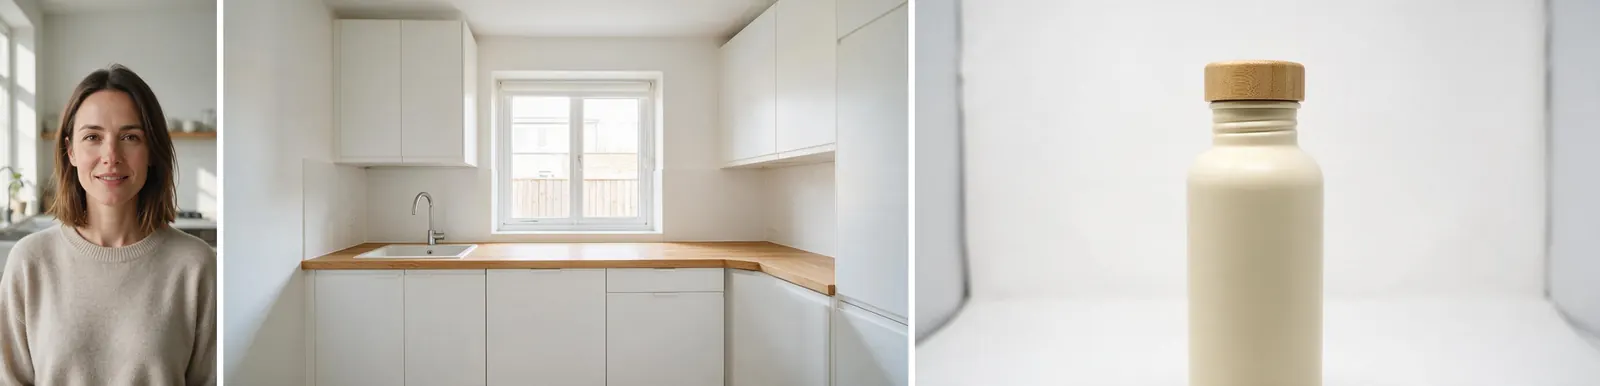 حزمة المراجع من
@image1 إلى @image3. الصور الثلاث كلها بدائل مولّدة بالذكاء الاصطناعي.
@image1 is the identity reference, @image2 is the environment, and @image3 is the product. Four-second shot: 0-1 s the woman stands at the counter holding the bottle; 1-3 s she sets the bottle down and reads its side; 3-4 s she looks up and holds still. End on a steady medium close-up with the bottle visible. Same wardrobe, same lighting direction throughout.
@image1 is the same identity reference, @image2 the same environment, and @image3 the same product as before. @video1 is the previous shot: continue directly from its last frame, same framing, wardrobe, and lighting. 0-2 s she turns the bottle so it faces the camera; 2-4 s she steps out of frame left and the camera holds on the bottle on the counter. No cuts back to the opening.
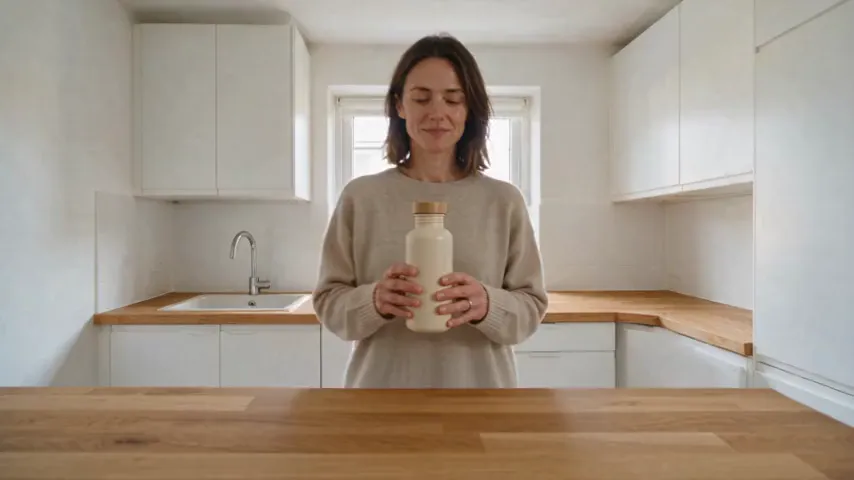
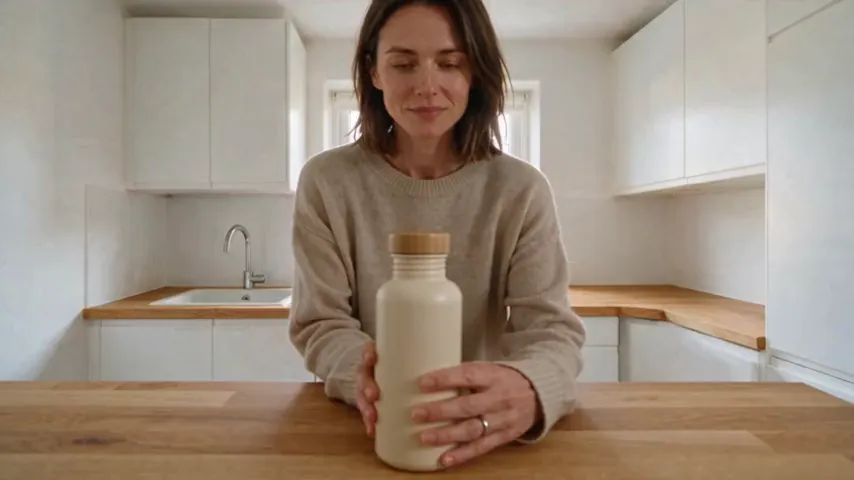
في الأعلى: الجزء الأول. في الأسفل: الجزء الثاني. كلاهما المقطع الكامل ومدته 4 ثوانٍ (بتشغيل متكرر). نقطة الوصل هي القفزة من نهاية الجزء الأول إلى بداية الجزء الثاني.
- ما انتقل عبر الوصل: وجهها وشعرها وكنزتها، والمطبخ من
@image2بحوضه ونافذته وسطحه من البلوط، واتجاه الإضاءة، والزجاجة، كلها متطابقة على جانبي نقطة الوصل. وأدى الجزء الثاني مهمته أيضًا: تترك الزجاجة، وتخرج من يسار الإطار، وتبقى الكاميرا على الزجاجة. - ما انكسر: ينتهي الجزء الأول بلقطة متوسطة مقربة وهي ترفع نظرها إلى الكاميرا. أما الجزء الثاني فيبدأ بلقطة أوسع، تقارب ما كان عليه الجزء الأول بعد ثانيته الأولى، وهي تنظر إلى الزجاجة. اتبع النموذج
@video1كاملًا كمرجع بدل أن يكمل من إطاره الأخير، لذا يقفز القطع إلى الوراء في حجم اللقطة وتعبير الوجه. - إخفاقات أخرى: أضاف الجزء الأول اقترابًا لم تطلبه المطالبة، ولا تظهر المرأة وهي تقرأ جانب الزجاجة.
الإصلاح الذي سنجربه تاليًا: سلّم ختام الجزء الأول فقط بدل المقطع كاملًا، فالتسليم القصير يترك للنموذج تأطيرًا سابقًا أقل لينسخه. وصِف أيضًا تأطير افتتاحية الجزء الثاني بالكلمات، مثل "open on the same medium close-up, she is looking at the camera"، حتى تتفق المطالبة والمرجع. احتفظ بالجزأين كملفين منفصلين حتى تجتاز نقطة الوصل المراجعة، ثم اجمعهما في محرر، ولا تغيّر الدقة أو نسبة العرض إلى الارتفاع بين الجزأين.
قائمة التحقق من المراجعة
| تحقق | شرط النجاح |
|---|---|
| الهوية | يبقى الوجه، والزي، وشكل المنتج، ومكان العلامة، والميزات المميزة قابلة للتعرف عليها |
| الحركة | ترتيب الأفعال، والاتصال، والوزن، ومسارات الأشياء مقبولة ومصداقية |
| المساحة | يشغل الأشخاص الموقع المقصود دون تغييرات في التخطيط غير مفسرة |
| الكاميرا | الإطار والحركة يتبعان التعليمات بدون قفزات غير مرغوبة |
| الصوت | الحوار، والموسيقى، والمؤثرات، والإيقاعات المرئية تتوافق مع الدور المطلوب |
| الحقوق | لديك إذن لاستخدام كل صورة، أو مقطع، أو صوت، أو شبيه، أو شعار، أو مسار موسيقي |
الأسئلة الشائعة
ماذا يعني R2V في Seedance 2.5?
R2V يعني الإشارة إلى الفيديو. النموذج يولد فيديو جديدًا مع استخدام الوسائط المقدمة لتوجيه الخصائص المختارة مثل الهوية، والحركة، والكاميرا، والأسلوب، أو التوقيت.
هل النموذج الأبيض هو نفسه كمرجع للأسلوب؟
لا. النموذج الأبيض أو التوقع المخطط الرمادي عادة ما يوضح التخطيط، والحجب، ومسار الكاميرا، والتوقيت. استخدم إطار مظهر منفصل عندما تحتاج إلى مواد نهائية، أو إضاءة، أو لون.
هل تحسين الشاشة الخضراء يساعد في مرجع الحركة؟
يمكنه جعل أداء المؤدي والحركة أسهل في القراءة لأن الخلفية أبسط. لكنه لا يضمن سلامة اليدين، أو نقاط الاتصال، أو الملابس، أو الهوية، أو الفيزياء في اللقطة المولدة.
هل يمكن لـ R2V نسخ حركة بالضبط؟
اعتبره كمرشد، وليس كالتقاط حركة. راجع الترتيب، والتوقيت، والوضعية، ونقاط الاتصال، ومسارات الأجسام. استخدم أدوات الالتقاط الحركي التقليدية أو أدوات التركيب عندما يكون من الضروري إعادة الإنتاج بدقة.
هل يمكنني استخدام الصوت كمرجع؟
Seedance AI توثيق API الخاص به يسرد مراجع الصوت لل Seedance 2.5. واجهة الفيديو إلى الفيديو على الويب التي تم اختبارها لم تعرض عنصر تحكم لتحميل مرجع صوتي، لذا تحقق من السطح الحالي قبل بناء سير العمل حوله.
أيهما أفضل للقطة منتج: R2V أم I2V؟
يعتمد ذلك على ما إذا كان يجب أن تكون الصورة هي الإطار الافتتاحي. في اختبارنا بالمطالبة نفسها، أبقى I2V المنتج أقرب ما يكون إلى الصورة، لكنه افتُتح على صورة الاستوديو البيضاء ثم قفز بقطع حاد إلى المطبخ الجديد. أما R2V فوضع المنتج في المطبخ الجديد منذ الإطار الأول، بلون أغمق قليلًا. وكلاهما يكلف الرصيد نفسه عند الطول والدقة نفسيهما.
كم عدد المراجع التي يجب أن أستخدمها؟
استخدم العدد الأقل الذي يغطي الموجز. اثنان إلى أربعة هو محاولة أولى عملية للعديد من اللقطات. أضف أخرى فقط عندما يكون لها دور واضح واحد لا يغطيه الحزمة الموجودة.
ماذا أفعل عندما تتعارض المراجع؟
سَمِّ الخاصية الفاشلة، احذف المصادر المكررة لتلك الخاصية، وأعلن أي مرجع متبقي له أولوية. اختبر الحزمة الأبسط قبل إعادة كتابة كل شيء آخر.
هل يضمن R2V اتساق الشخصية؟
لا. يمكن لمرجع هوية نظيف وحزمة غير متعارضة تحسين السيطرة، لكنك ما زلت بحاجة لمراجعة الوجه والشعر والملابس والنسب والاستمرارية في كل لقطة.
ما الأذونات التي أحتاجها؟
استخدم الأصول التي تملكها أو لديك ترخيص لاستخدامها. تحقق من الحقوق الخاصة بالأشخاص، الأصوات، الموسيقى، اللقطات، المنتجات، العلامات التجارية، والمواقع. النتيجة المُنشأة لا تلغي القيود المرتبطة بالمادة الأصلية.
المصادر والمنهجية
اختبارات توليد أجريناها بأنفسنا: في 14 أكتوبر 2026، ولّدنا على Seedance 2.5 زوج I2V مقابل R2V بالمطالبة نفسها وسلسلة المقطعين، بدقة 480p ومدة 4 ثوانٍ، مرة واحدة لكل منها، باستخدام صور بديلة مولّدة بالذكاء الاصطناعي. تم التحقق من قدرات وحدود المنصة في 6 أغسطس 2026. كانت المراجع الرئيسية هي Seedance AI وثائق النموذج, Dreamina Seedance نظرة عامة على R2V 2.5, دليل الإشارة الحركية، و Seedance صفحة منتج 2.5. يمكن أن تتغير حدود المنتج، لذا استخدم الحدود الموضحة في واجهتك الحالية أو وثائق حسابك.
قم بإنشاء أول مجموعة R2V خاصة بك
افتح Seedance 2.5 على Seedance AI، اختر مرجعاً رئيسياً واحداً، أضف مصدراً للمتطلب الثانوي الأكثر صعوبة، وامنح كل أصل مهمة واحدة فقط. مجموعة أصغر تجعل النتيجة الأولى أسهل في التشخيص والمحاولة الثانية أسهل بكثير للتحسين.